Cuando la integración reintenta, el pedido entra dos veces
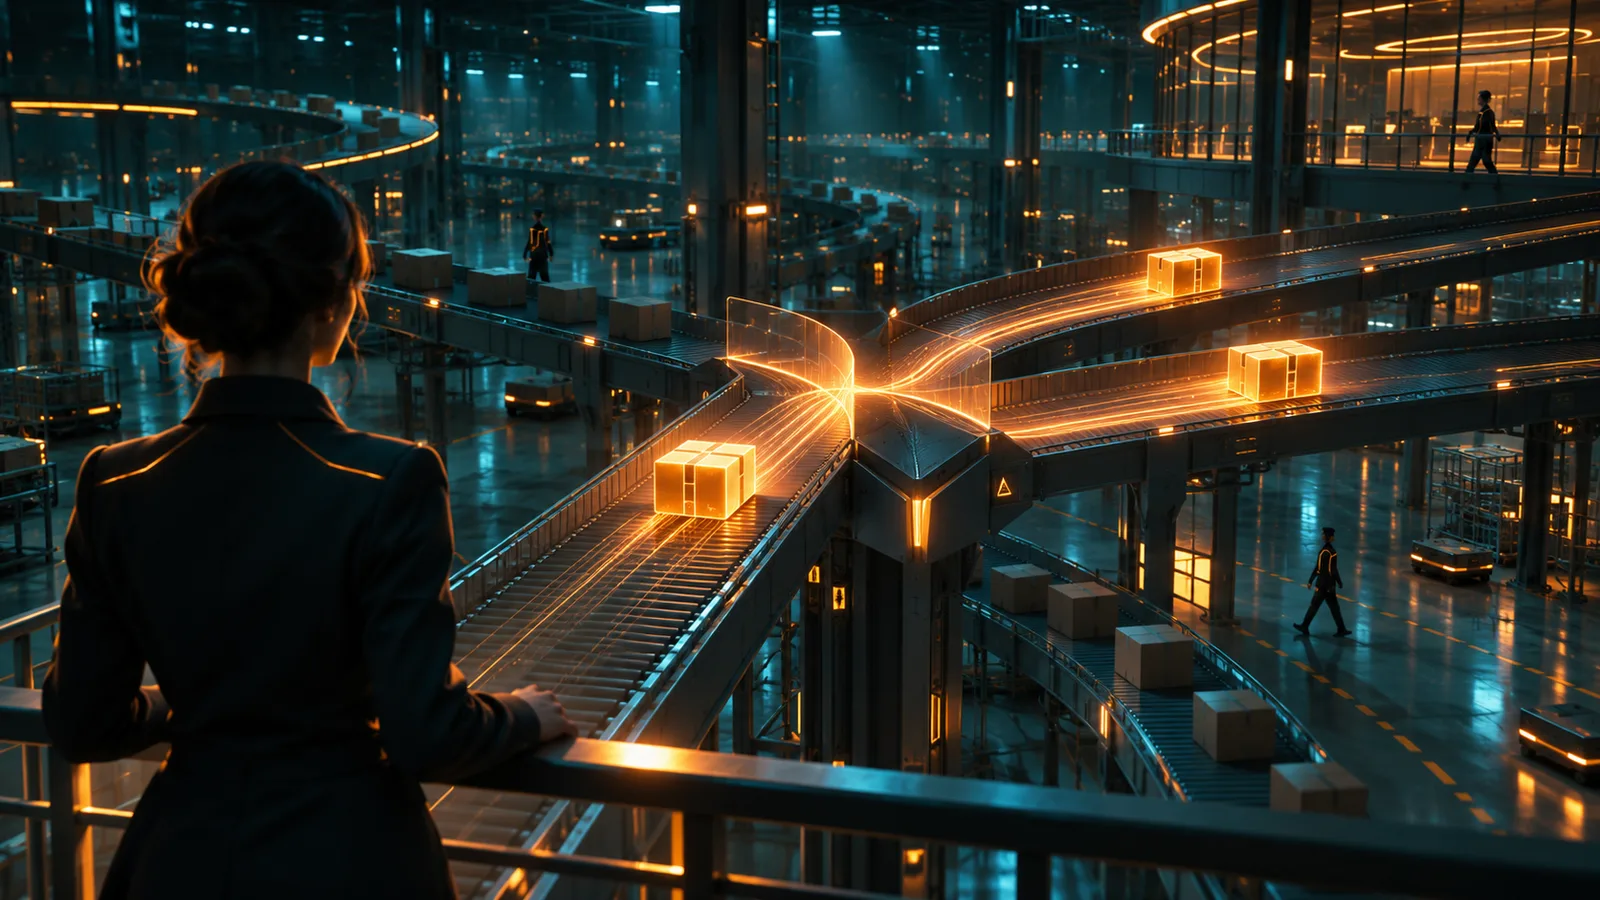
La integración crea dos veces el mismo registro porque un tiempo agotado no dice si el primer envío funcionó. El sistema de origen lo intenta de nuevo y el de destino no sabe que es el mismo pedido. La salida es dar a cada operación un identificador único y decidir, en el diseño, qué ocurre cuando llega otra vez.
¿Por qué la integración duplica el pedido?
Porque la red no entrega certeza. Cuando el sistema de ventas manda un pedido al ERP y la respuesta no vuelve, hay dos mundos posibles: el pedido no llegó, o llegó y se perdió la confirmación. Desde el lado de quien envió, los dos son idénticos.
El artículo de Malcolm Featonby en la Amazon Builders' Library describe exactamente ese punto muerto. Cuando una llamada para crear un recurso agota el tiempo, reintentar puede generar dos recursos donde se quería uno, con consecuencias que el autor califica de graves. Esperar no lo resuelve, porque la duda sigue. Rendirse tampoco, porque a veces el pedido de verdad no llegó.
Reintentar es la elección sensata en la mayoría de los casos, y por eso las integraciones reintentan solas. El problema no está en el intento. Está en el destino, que trata la segunda llegada como un pedido nuevo.
¿Qué propone la documentación técnica?
Un identificador generado por quien envía, único por operación. Amazon lo llama client request identifier: las solicitudes del mismo remitente con el mismo identificador se tratan como la misma operación. En la segunda llegada, el destino no crea nada. Devuelve una respuesta equivalente a la primera, para que el remitente siga como si hubiera recibido la confirmación a la primera.
La documentación de Stripe describe el mismo mecanismo para su API de pagos. Con la clave de idempotencia, el cliente puede repetir la llamada tras un fallo de conexión sin crear un segundo objeto. Stripe guarda el código de estado y el cuerpo de la primera respuesta y los devuelve en las repeticiones. Si la misma clave llega con parámetros distintos, la API la rechaza, para evitar un uso erróneo.
Hay una pieza que el texto de Amazon deja explícita: registrar el identificador y ejecutar la operación deben ocurrir juntos, o no ocurrir. Si el identificador se guarda y la operación falla, el reintento se ignora y el pedido nunca existe.
El tema está en proceso de estandarización. Un borrador del grupo de trabajo HTTPAPI de la IETF, draft-ietf-httpapi-idempotency-key-header (revisión 08, del 22 de octubre de 2026), propone una cabecera estándar para ese identificador. Hasta esta revisión, no es una norma publicada, y conviene leerlo como señal de que la práctica es lo bastante común como para merecer un estándar.
¿Qué decisiones tiene que tomar el diseño?
Tres, y ninguna es de herramienta.
La primera es dónde nace el identificador. Debe crearse una sola vez, en el sistema que origina la operación, y reutilizarse en cada intento. Si cada intento genera uno nuevo, el destino nunca reconoce el repetido.
La segunda es cuánto tiempo recuerda el destino. Stripe informa que, en la versión 1 de su API, las claves pueden eliminarse pasadas al menos 24 horas. Ese número es de Stripe, no una regla. Lo que vale para su operación es la pregunta: ¿cuál es la mayor demora plausible entre el primer intento y el último? Una cola que queda parada el fin de semana necesita más memoria que un formulario web.
La tercera es qué responde el destino al repetido. La respuesta correcta no es «este pedido ya existe», que el remitente leería como un fallo. Es el resultado del primer envío, igual al que habría recibido.
¿Cómo se ve esto en una pyme?
El ejemplo siguiente es una hipótesis para ilustrar, no un caso medido. Una distribuidora tiene un sistema de ventas y un ERP conectados por una integración. A fin de mes el ERP se vuelve lento y algunas escrituras tardan más que el límite de espera. El sistema de ventas no recibe confirmación y reenvía.
En parte de esos casos, el primer envío ya estaba guardado. El ERP ahora tiene dos pedidos iguales. El almacén prepara dos veces y finanzas ve dos asientos. El cliente puede recibir dos cobros o dos entregas. Nadie ve el error en el momento, porque cada sistema, por separado, funcionó. Quien lo descubre es la persona que concilia al final de la semana, comparando línea por línea.
Con el identificador, el segundo envío llega al ERP, que reconoce la operación y devuelve el resultado del primero. No se crea nada. El sistema de ventas conserva la confirmación que esperaba. El costo está en el diseño inicial y la ganancia aparece como ausencia de trabajo: la conciliación deja de cazar duplicados.
En operaciones que sincronizan después, como Reatop, que registra residuos hospitalarios en campo, con uso offline y sincronización posterior, el reenvío forma parte de la rutina. Allí la pregunta sobre el repetido vale desde el primer día del proyecto.
¿Cómo ve la dirección el resultado?
Por lo que la operación deja de hacer. No encontré un indicador público confiable sobre la frecuencia de duplicados en integraciones de pymes, y este artículo no va a inventarlo. El número que importa es el suyo, y sale de un conteo simple en su propia operación.
Cuente, por mes, cuántos registros duplicados encuentra y corrige la operación, cuánto tarda cada corrección y quién la hace. Ese es el costo actual. Tras el cambio, el mismo conteo muestra si el diseño funciona. Si la cifra no baja, el identificador no se está reutilizando entre intentos, y eso es un hallazgo útil.
Este razonamiento es pariente de cuándo sabrás que la automatización se detuvo: el fallo que no hace ruido suele ser el que más tarda en aparecer. Y la lista de cinco fallas que comprometen las integraciones internas ayuda a ver dónde más suele ceder la unión entre sistemas.
Preguntas frecuentes
¿Cómo mido el resultado, si lo que cambia es algo que deja de ocurrir?
Contando los duplicados antes y después. Registros duplicados encontrados por mes, tiempo dedicado a corregir cada uno y quién lo corrige. Si la cuenta muestra horas de conciliación cada semana, ese es el costo que el proyecto debe eliminar, y la comparación vive dentro de su propia operación.
¿Esto exigirá mucho tiempo de mi equipo para implementarlo?
El esfuerzo más costoso es de diseño: decidir dónde nace el identificador, cuánto recuerda el destino y qué responde al repetido. Es una conversación entre quienes operan y quienes construyen, y su duración depende de cuántas integraciones existan. El costo crece cuando la decisión se posterga, porque entonces la corrección pasa por registros que ya existen.
¿Y si el sistema del otro lado no acepta identificador? ¿No deja eso el cuello de botella intacto?
Depende del sistema. Cuando el destino no reconoce el identificador, la verificación puede hacerse en el origen: consultar si el pedido ya existe antes de reenviar. Es más lento y más frágil, pero es una barrera. Saber que el destino no ofrece esa garantía ya cambia la decisión de compra y de integración.
El siguiente paso
Si hoy nadie puede decir cuántas de sus integraciones reenvían solas y qué hace cada una con el repetido, el Diagnóstico de Arquitectura Operacional es una conversación de 30 minutos para mapearlo. Hable con un arquitecto.
Lee también
Cases relacionados
¿Reconociste tu operación en este artículo?
Agenda el Diagnóstico de Arquitectura Operacional: 30 minutos para mapear dónde está el cuello de botella de tu operación. Sin propuesta en la primera conversación.
Agendar diagnóstico